逻辑调度模型
NVIDIA GPU 通过 grid, block 和 thread 建立逻辑上的调度模型,kernel 启动一个 Grid ,Grid 里面是若干个 Block,Block 里面是若干个 Thread。这是一个理想化的执行模型,每个 thread 都有独立编号,在逻辑上独立运行,数量可以远超过硬件实际同步执行的并行度,编译器负责将其铺到硬件上面。
硬件执行模型
一整个 GPU 由若干个 SM 组成,每个 SM 内部有 warp scheduler、寄存器堆、shared memory/L1,真正执行指令的最小硬件调度单元是 warp,固定 32 个线程一组,以 SIMT 方式执行。
两者映射关系
- Grid → GPU:一次 kernel 启动覆盖整个 GPU 的所有 SM。
- Block → SM:一个 Block 被硬件调度器分配到某一个 SM 后就常驻不迁移,直到执行完毕。所以
__syncthreads()只能在 Block 内同步、shared memory 的作用域是 Block(=SM) 级别。一个 SM 可以同时驻留多个 Block/多个 Warp(受限于寄存器和 shared memory 容量),这决定了 occupancy。 - Thread → Warp:每连续 32 个 Thread(按 threadIdx 排列)被打包成一个 Warp。
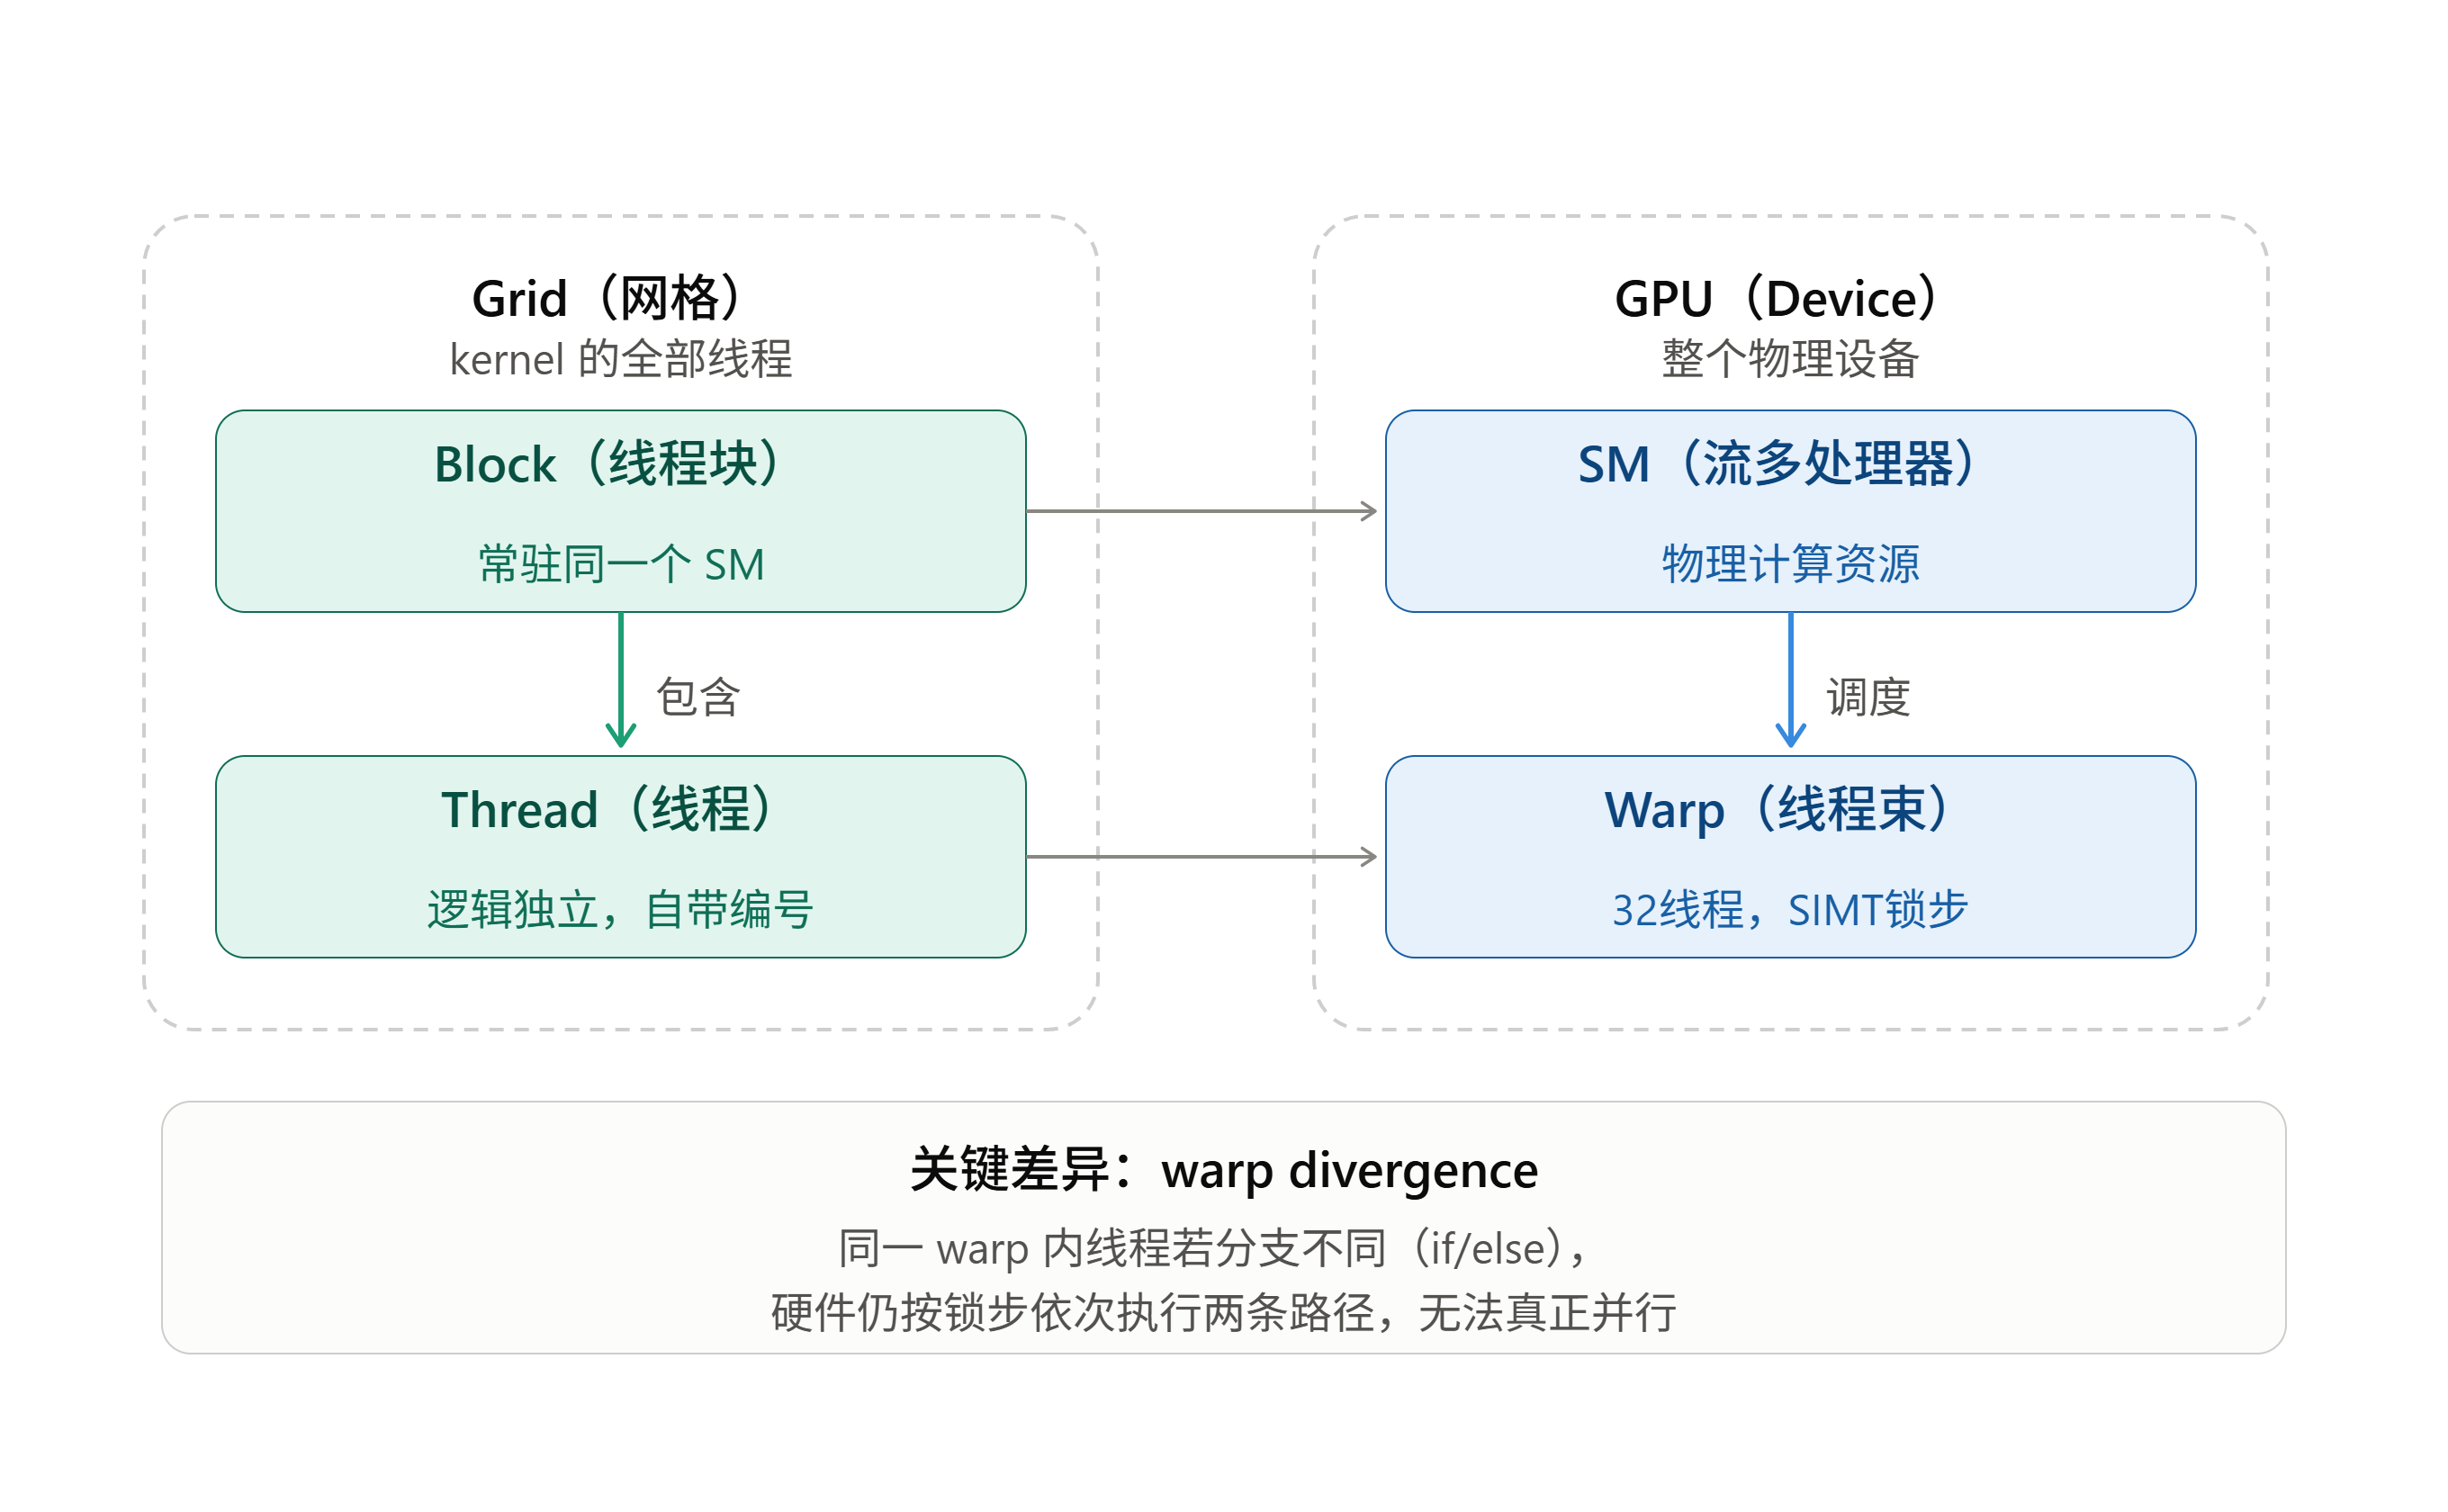
- 图中下方说明一个关键点:如果同一个 warp 内的线程走了不同分支,硬件会将两条路径都跑一遍、用 mask 关闭不该执行的线程,这就是 warp divergence。
存储模型
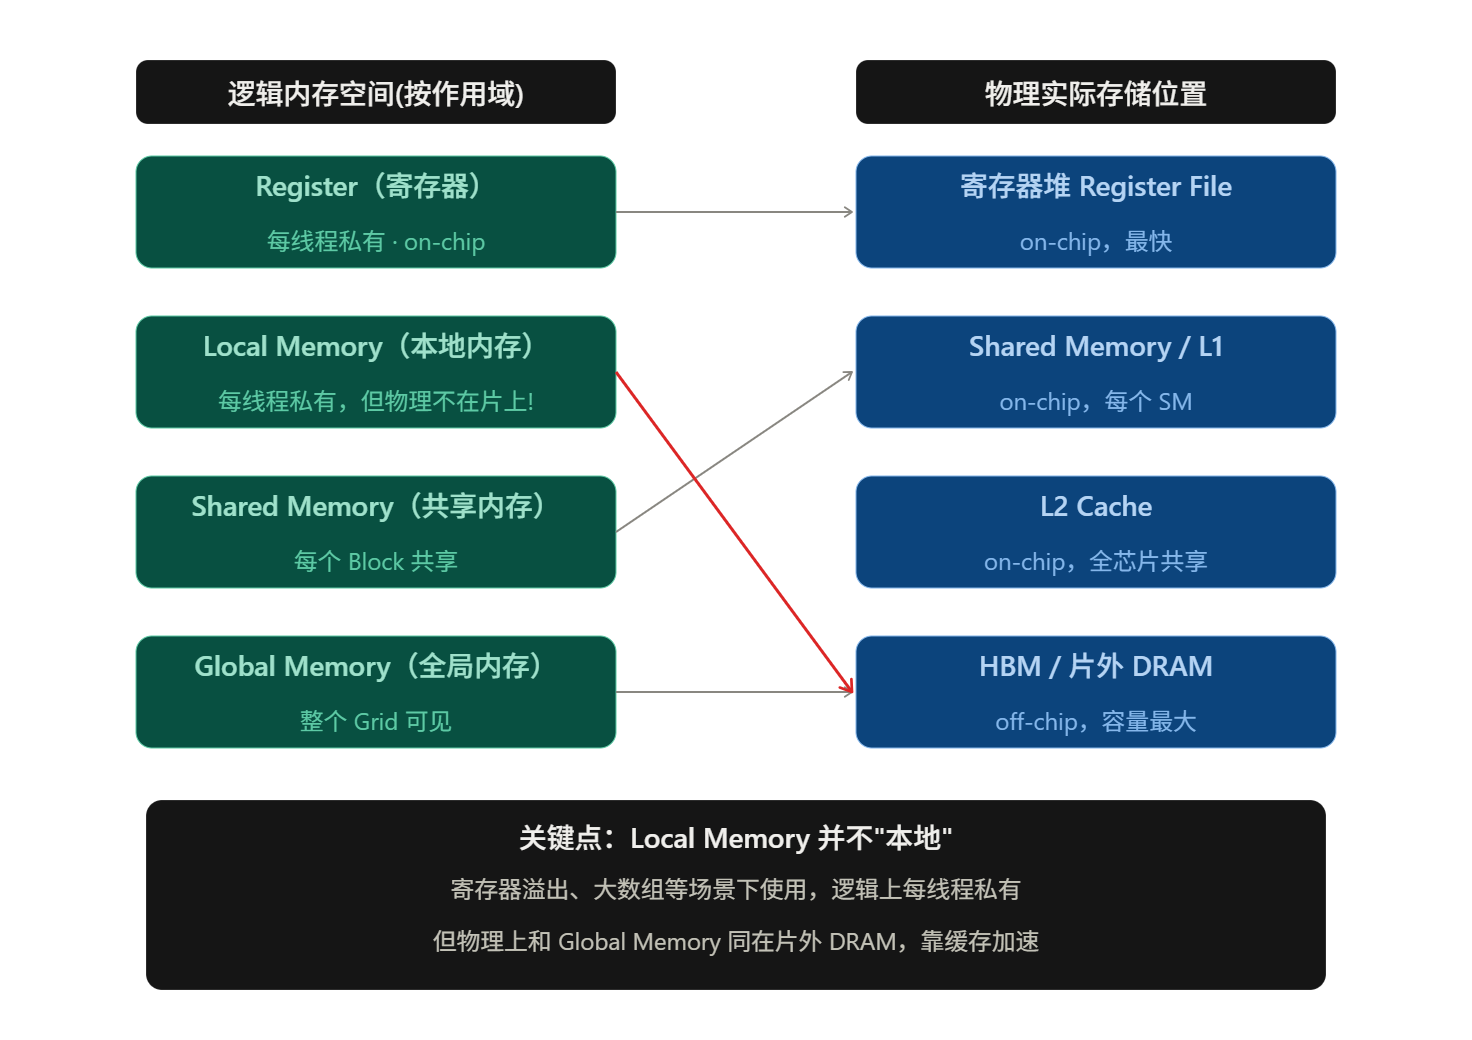 GPU 的存储可以从两个角度来看:一个是数据实际存放的物理位置,另一个是 CUDA 编程模型中按作用域划分的逻辑内存空间。两者大部分能对应上,但也有例外,所以分开来理解会更清楚。
物理存储层级
| 物理层级 | 位置 | 大致容量/延迟(以 H100 为参考) |
|---|---|---|
| Register File | 片上,每个 SM 一份 | 每 SM 256KB,每线程最多 255 个 32-bit 寄存器,延迟约 1 cycle |
| Shared Memory / L1 | 片上,每个 SM 一份 | 每 SM 256KB,其中 shared memory 最多可配置 228KB,延迟约 20–30 cycle |
| L2 Cache | 片上,全芯片共享 | 50MB,延迟约 200 cycle |
| HBM | 片外 DRAM | 80GB,带宽约 3.35 TB/s,延迟几百 cycle |
- 越往下容量越大,同时延迟越高、带宽越低。HBM 是整个层级里带宽最低的一层,所有 SM 的 shared memory 加起来的聚合带宽比 HBM 高一个数量级。
- Shared memory 和 L1 是同一块 SRAM,从 Volta 开始采用统一设计,两者的切分比例可以通过
cudaFuncSetAttribute配置。 - L2 从 Fermi 开始就存在,Ampere 之后容量大幅增加(V100 6MB → A100 40MB → H100 50MB),并且可以通过
cudaAccessPolicyWindow设置一段数据在 L2 中的驻留策略。L2 负责不同 SM 之间的数据复用,全局原子操作也在这一层完成。 - 可以看出往下越慢但是存储空间越大,往上越快但是越小。所以 tiling 类算法需要将数据尽量往上面搬,先从 HBM 里面读进 shared memory,在 shared memory 里面反复使用,再让每个线程将中间结果放进寄存器算,减少对于 HBM 的访问。
逻辑内存空间
| 逻辑空间 | 作用域 | 物理位置 | 管理方式 |
|---|---|---|---|
| Register | 单个 Thread | 寄存器堆 | 编译器分配 |
| Local Memory | 单个 Thread | 片外 DRAM(经过 L1/L2 缓存) | 编译器自动使用 |
| Shared Memory | 单个 Block | SM 上的 SRAM | 程序员显式管理 |
| Global Memory | 整个 Grid,跨 kernel 持久存在 | HBM(经过 L1/L2 缓存) | 程序员通过 cudaMalloc 分配 |
| Constant Memory | 整个 Grid,只读 | 片外 DRAM + 每个 SM 的 constant cache | 程序员通过 __constant__ 声明 |
- 这里最容易混淆的是 local memory。它的作用域和寄存器一样是线程私有,但物理上位于片外 DRAM,访问性能接近 global memory。以下几种情况编译器会使用 local memory:
- 寄存器溢出(register spilling):一个线程需要的寄存器超过了硬件上限,多出来的部分只能放到 local memory;
- 用运行时变量作下标访问局部数组,因为寄存器无法按下标寻址;
- 局部数组或结构体过大,编译器判断放在寄存器里不划算。
- 编译时可以用
nvcc --ptxas-options=-v查看 local memory 的用量,写高性能 kernel 时这一项应该尽量为 0。 - Shared memory 物理上在 SM 上,逻辑作用域是 Block。一个 SM 上可以同时驻留多个 Block,每个 Block 只能访问属于自己的那一部分。所以 Block 申请的 shared memory 越多,一个 SM 能同时驻留的 Block 就越少,occupancy 也就越低。
- Shared memory 和 L1 用的是同一块硬件,区别在于管理方式:shared memory 由程序员显式读写,L1 由硬件自动缓存 global/local memory 的访问。
- Constant memory 总共 64KB,适合所有线程读取同一个地址的场景(比如卷积核参数),这时一次读取可以广播给整个 warp。如果 warp 内线程读取的地址各不相同,访问会被串行化。
访存模式
除了数据放在哪一层,访问的方式同样会影响性能。
Global Memory:合并访存
- 一个 warp 的 32 个线程同时访问 global memory 时,硬件会把这些访问合并成若干个 32B 的内存事务(sector)。
- 如果 32 个线程访问连续且对齐的地址(比如每个线程读一个 float,一共 128B),只需要 4 个事务;如果访问地址很分散,最坏情况下需要 32 个事务,有效带宽大幅下降。
- 所以在设计数据布局时,通常让相邻线程访问相邻地址。
Shared Memory:Bank Conflict
- Shared memory 被划分为 32 个 bank,每个 bank 宽 4 字节,连续的 4 字节地址依次分布在相邻的 bank 上。
- 同一个 warp 中如果有多个线程访问同一个 bank 的不同地址,这些访问会被串行化,称为 bank conflict。多个线程访问同一个地址时会广播,不产生冲突。
- 典型的例子是按列访问
float tile[32][32]:同一列的 32 个元素恰好落在同一个 bank 上,产生 32 路冲突。常见解决方法:- padding:把数组声明成
float tile[32][33],让每行错开一个 bank; - swizzle:通过对地址做异或变换打散 bank 分布,TileLang/CUTLASS 中 layout 相关的 swizzle 就是在处理这个问题。
- padding:把数组声明成
数据搬运路径的演进
- Ampere 之前:数据从 HBM 搬到 shared memory 需要经过寄存器中转,先 load 到寄存器,再 store 到 shared memory,会占用寄存器和指令发射资源。
- Ampere:引入
cp.async,可以直接从 global memory 异步拷贝到 shared memory,绕过寄存器。 - Hopper:
- 引入 TMA(Tensor Memory Accelerator),由单个线程发起整块多维 tile 的搬运,地址计算和边界处理都由硬件完成,搬运完成后通过 mbarrier 通知;
- 引入 Distributed Shared Memory,同一个 Thread Block Cluster 内的 Block 可以直接读写彼此的 shared memory,不需要经过 L2/HBM。
- Blackwell(SM100):在寄存器堆旁边新增了一块专用的片上存储 Tensor Memory(TMEM),每 SM 256KB(128 lanes × 512 columns × 32 bit),专门用来存放
tcgen05.mma的累加器,需要用tcgen05.alloc/tcgen05.dealloc显式分配和释放。
GPU 执行计算的方式
GPU 线程跟 CPU 中的线程概念不同,CPU 中的线程具有实际的 context,但是 GPU 中的线程只是一种可以被硬件批量调度的逻辑抽象,所以如果“申请”了 100万个线程,并不会同时为 100万个线程都分配完整的独立硬件资源,而是在 SM 上只会同时驻留少量 block,当本轮 block 完成以后,GPU 再安排其他 block 进来。
正是由于 CUDA 中的 block 和 thread 是逻辑执行模型,所以 GPU 会让硬件自己决定怎么将 block 和 thread 映射到实际硬件上面,因此同一个 kernel 可以运行在不同 GPU 上面,程序本身不需要知道 GPU 到底有多少实际执行资源。但是核心/SM 数量对于性能来说非常重要,能同时驻留更多 block 的 GPU 通常性能更强。
用一句话来说就是:硬件资源决定性能,logical thread/block 数量决定工作量。
CPU 发起 kernel launch 后,GPU 的硬件 work scheduler 会将 kernel 中的 thread blocks(CTAs)动态分配到具有足够资源的 SM 上执行。一个 block 被分配到某个 SM 后,会占用该 SM 的一部分寄存器、shared memory、thread/warp 等资源,并在其生命周期内驻留在该 SM 上。当某个 SM 的剩余资源不足以再驻留一个 block 时,该 block 不会被分配到这个 SM,而是等待其他 SM 或等待某个 SM 上已有 block 完成并释放资源后再被调度。
两条计算路径
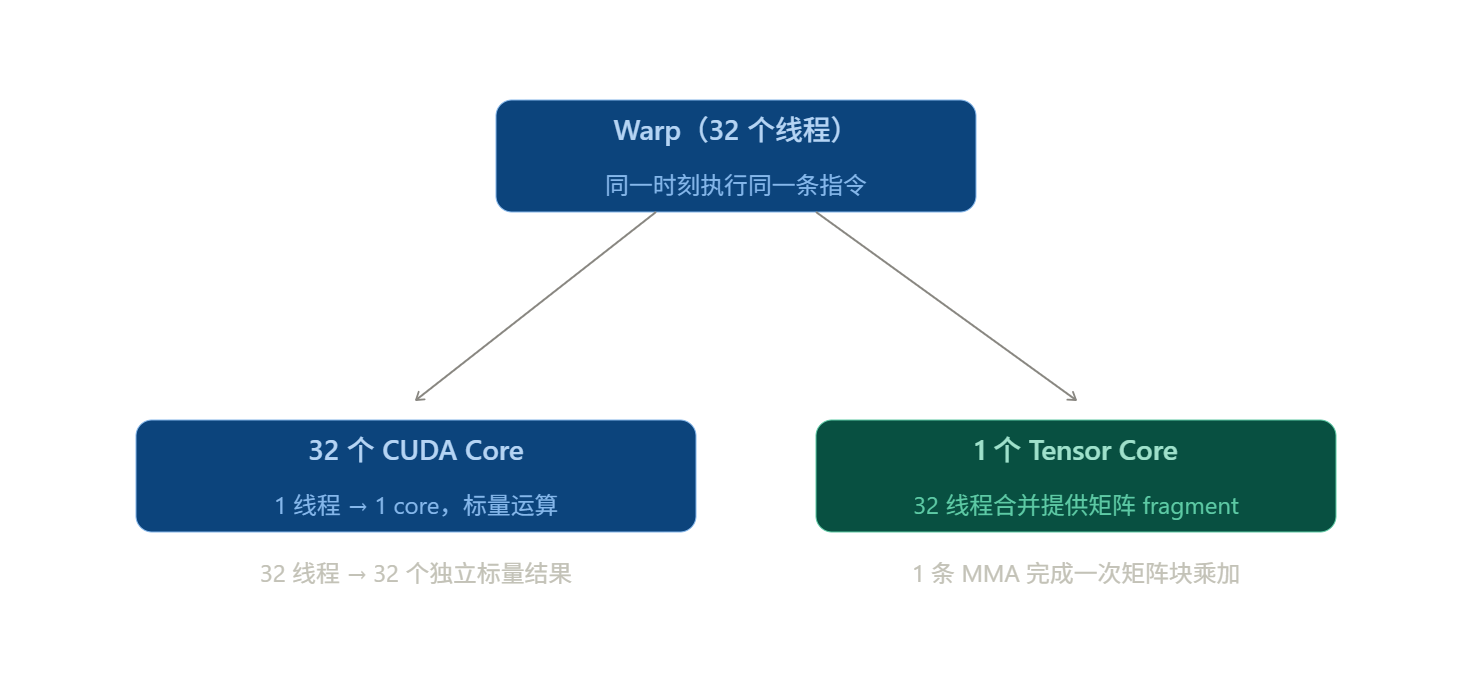 Nvidia 的现代 GPU 中有两条计算路径,分别使用片上的 Tensor Core 和 CUDA Core。
CUDA Core 路径
- 每个 CUDA core 就是一个简单的 ALU,固定绑定 warp 里面的某一个 lane,但是 32 个 core 对应 32 个 lane 是一个理想化的模型,实际宽度因架构而异,比如 A100 的一个 sub-partition 中只有 16 个 FP32 单元,一条 warp 的 FP32 指令要分成两个 cycle 才能发完;H100 增加到 32 个。
- Fetch/Decode 单元给这 32 个 core 发同一条标量指令(如 FADD、FMUL),每个 core 各自从自己线程的寄存器里面取、算。
- 每个线程只能操作自己私有的标量数据,所以如果想让 32 个线程凑成一个矩阵做乘法,需要手写循环,一个元素一个元素地算。
Tensor Core 路径
- 使用 Tensor Core 的时候,32 个线程各自的寄存器里面存的不再是标量,而是一小块矩阵里面分摊到的若干元素,比如 A 矩阵的一部分,按照 Tensor Core 规定的固定 layout 摆放。
- 整个 warp 合起来发出
mma.sync指令,硬件会一次性将这一小块 A、B 矩阵相乘并累加到 C 矩阵上面。
这里需要注意,对于一个 warp 能用 Tensor Core 完成什么规模的矩阵乘法这个问题,不同架构的 GPU 的答案完全不一样:
Ampere 及更早
一个 warp 做一次矩阵乘法。从 Volta 开始,Ampere(SM80) 扩展了现代的 warp 级 MMA PTX 指令族 mma.sync.aligned,一个 warp 协作完成一次 矩阵乘加。常见规格:
| 数据类型 | 一次 mma.sync 完成的规模 (M×N×K) |
|---|---|
| FP16 / BF16 | 16×8×16 |
| TF32 | 16×8×8 |
| INT8 | 16×8×32 |
也就是说,32 个线程各自贡献寄存器里面的一小块数据,合起来一条指令完成一个乘加块。
Hopper
Hopper 引入了 wgmma(warp group MMA),而一个 warpgroup 由 128 个连续线程组成,wgmma.mma.async 指令是由 warpgroup 内全部 128 个线程集体执行的。
规模也随之变大很多:Hopper 上最大的 WGMMA 规模是 ,这条指令需要 4个 warp 共同完成,结果放在线程寄存器里面。具体规模:
| 数据类型 | K 固定值 | N 可选范围 | 典型/最大规模 |
|---|---|---|---|
| FP16 / BF16 | 16 | 8 的倍数,最大 256 | 64×256×16 |
| FP8 (e4m3/e5m2) | 32 | 同上 | 64×256×32 |
这里需要注意的一点是,wgmma 是异步的,wgmma 指令通过 fence、commit_group、wait_group 这套机制来排序,而不是像 mma.sync 那样同步完成,发出指令后 warpgroup 可以去做别的事(比如用 TMA 继续搬下一块数据),所以 Hopper 上面能实现较为高级的流水线和 persistent kernel。
Blackwell
Blackwell(SM100) 引入了第五代 Tensor Core 的新 PTX 指令族 tcgen05.mma,计算吞吐是 Hopper wgmma 指令的 2 到 4 倍。但是变化最大的是发起指令的方式:tcgen05 操作现在由单个线程代表整个 CTA 发出,不是像之前那样在 warp 或者 warpgroup 层面发起。
CTA 中的线程工作不再是对称的——大部分线程负责用 TMA 搬数据、做 epilogue 这些辅助工作,只有一个线程会去发送 MMA 指令,硬件在背后将这条指令的工作自动铺到整个 CTA(乃至一对 CTA)上。
同时存在另一个结构性变化。之前累加器 C/D 的结果都是存放在寄存器堆里面,Blackwell 新增了一块专用的片上内存 Tensor Memory(TMEM),tcgen05.mma 直接在 TMEM 里面读写寄存器,腾出寄存器堆给其他工作用,这一块内存需要显式 tcgen05.alloc/tcgen05.dealloc 来分配和释放。
Blackwell 支持两种协作粒度:
- cta_group::1(单 CTA):一条 tcgen05.mma 由一个 CTA 内部完成。
- cta_group::2(CTA 对/2-SM 模式):同一个 cluster 里、位于同一个 TPC(两个相邻 SM 组成)的两个 CTA,可以联合执行同一条 MMA 指令,共享操作数、把 tile 规模再翻一倍。这是 Hopper 完全没有的能力。
大致规模对比:
| Hopper (wgmma) | Blackwell (tcgen05.mma) | |
|---|---|---|
| 发指令线程数 | 128(1 个 warpgroup = 4 warp) | 1 个线程(代表整个 CTA,甚至跨 2 个 CTA) |
| 累加器位置 | 寄存器(RMEM) | 专用 TMEM |
| 协作范围上限 | 1 个 SM 内的 1 个 warpgroup | 1 个 CTA,或 2 个 SM(TPC)联合 |
| 单次最大规模 | 64×256×16(FP16) | 最大到 m256n128k64 这个量级(需 2-CTA 模式) |
| 支持精度 | FP16/BF16/TF32/FP8/INT8 | 新增 FP6、FP4(含 NVFP4 块缩放格式) |
- 但是不是所有 Blackwell 架构的芯片都一样,只有数据中心卡(B100/B200,SM100)才拥有完整的 TMEM+CTA-pair 能力,消费级显卡(比如 RTX 50 系列,SM120)不支持 cluster>1,也就用不了 tcgen05 的 2-CTA 协作模式,编译的时候甚至可能直接干脆不生成 tcgen05 指令,回退到类似 Hopper 的路径。
一些其他问题
- 为什么 GPU 需要为 block 内每个线程分配 context?
- 假设一个 SM 一次只能并行执行 128 个线程,为什么一个 CUDA block 可以有 256 个线程?为什么不先执行前 128 个,再执行后 128 个?
- 一个 block 是一个整体的并发执行单位,即使一个 SM 的硬件能力不足以同时执行 block 中的所有 threads,SM 仍然必须为整个 block 的 threads 保留足够的 execution context,使它们能够被 scheduler 调度,否则像
__syncthreads()这样的线程间依赖就可能导致死锁。
- 为什么 CUDA 不允许依赖 block 执行顺序?
- 因为 CUDA 不保证不同 block 之间的执行顺序。
- 假设这样一个情况:一个 SM 只能同时容纳一个 CUDA block,现在有两个 block,block 0 的执行会修改 flag,但是 block 1 的执行依赖 flag,如果 GPU 先执行了 block 1,这时候 block 1 占用着 SM,但是不能实际执行代码,block 0 也不能进入 SM,flag 不会改变,于是发生了死锁。
- 因此 CUDA kernel 的正确性通常不能依赖 block 间的执行顺序。
- 什么是 persistent kernel?
- 传统的 kernel 通常这样设计:Grid 里面每个 block 负责处理一个固定的工作,算完就退出。如果总共有 1000 个 tile 要处理,但是 GPU 一次只能同时跑 100 个 block(等于 SM 数量),那么调度器就需要反复地将新 block 塞进空出来的 SM,每一次塞 block 的操作都需要重新走一遍 launch(分配寄存器/shared memory、初始化执行上下文)和 exit 的开销。
- Persistent kernel 则不同,它只会启动刚好等于硬件资源上限的 block 数量(比如每个 SM 正好一个或者几个 block,让它们将 SM 占满),然后在 kernel 内部写一个循环,每个 block 自己去认领下一个还没处理的 tile,算完不会退出,直接继续认领下一个,直到所有 tile 都处理完才真正退出。整个过程只会 launch 一次。
- 这样做首先能省掉重复的 launch/exit 开销;其次,配合上 wgmma 等异步指令,可以实现流水线,让计算和访存重叠;这也是一种更精细的负载均衡,如果某些 tile 计算量不均匀,先完成的 block 可以多认领几个 tile,实现类似
schedule(dynamic)的动态调度。