HBM
HBM 特别适合 AI 基础设施,因为带宽极大,普通 CPU 的内存总线可能是 64 bit,但是 GPU 的内存总线能达到 1024 bit。
HBM 其实是 DRAM 的 3D 堆叠,HBM 将很多 DRAM 芯片堆叠起来,通过 TSV(Through-Silicon Via) 连接,因此走线更短,接口更宽,可以并行传输很多 bit,功耗效率较高。
Nvidia 的 GPU 中,从 A100 到 VR300,HBM 容量和带宽一直在涨,VR300 的 HBM 带宽已经涨到 A100 的 15.7x。
多 GPU 的并行方式
Transformer 中可以从多个维度做并行:
Data Parallel (DP)
Tensor Parallel (TP)
Pipeline Parallel (PP)
Expert Parallel (EP)
Sequence Parallel (SP)
Context Parallel (CP)
下面是四种并行方式和对应的常用通信原语:
| Parallelism | 典型通信 |
|---|---|
| TP | AllReduce / ReduceScatter + AllGather |
| PP | Send / Receive |
| EP | All-to-All |
| DP | AllReduce / ReduceScatter + AllGather |
TP(Tensor Parallel)
TP 是将单层内部的权重矩阵切开(比如 Megatron 里面 Attention/MLP 的 column-parallel + row-parallel 组合)。典型模式是:
- 第一个线性层按列切,每张卡拿到的是完整输入、部分输出通道,不需要通信;
- 紧接着的第二个线性层按行切,这时候每张卡算出来的只是最终结果的一个部分和,必须把这些部分和加起来才是真正的层输出,这就是 AllReduce。
为什么是这样切?以 MLP 为例: 。
- 第一个矩阵 按列切:每张卡拿到 的一部分列 ,输入 每张卡都是完整的。这样第 张卡算出来的 本身就是最终结果 的一个完整列子集,不是部分和。既然是完整结果的一部分,直接在本地对 做 GELU 就是对的,不需要通信。
- 第二个矩阵 按行切:因为 已经按列(隐藏维)分片在各卡上,这个维度正好是第二次矩阵乘法 的 contraction 维。 按行切之后,每张卡算的 就是最终输出 的部分和,必须 AllReduce 才能得到真正的 。
Attention 中是同样的道理: 按 head 维列切(各 head 独立,无需通信),输出投影 按行切需要 AllReduce 把各 head 的贡献加起来。每个 block 只通信一次,不需要每个矩阵乘法之后都通信。
为什么 TP 可能需要 ReduceScatter + AllGather ?
这个主要出现在 Megatron-SP(Sequence Parallel + TP) 场景。
原始 TP 有个浪费:LayerNorm、Dropout 这类操作不能被 TP 切分,因为它们是沿着 hidden 维做归一化,TP 恰好将 hidden 维切了,所以 vanilla Megatron 在每张卡上都冗余地存一份完整序列长度、完整 hidden 维地激活值去做这些操作,这样每张卡都会重复计算同样的 LayerNorm,还浪费显存。
Megatron-SP 的做法是:将 LayerNorm/Dropout 这些沿着 sequence 维切分到各卡,因为这类逐 token 操作天然可以按 token/序列切。我们先看 SP 的 vanilla Megatron-TP,一个完整的 Transformer block 长什么样:
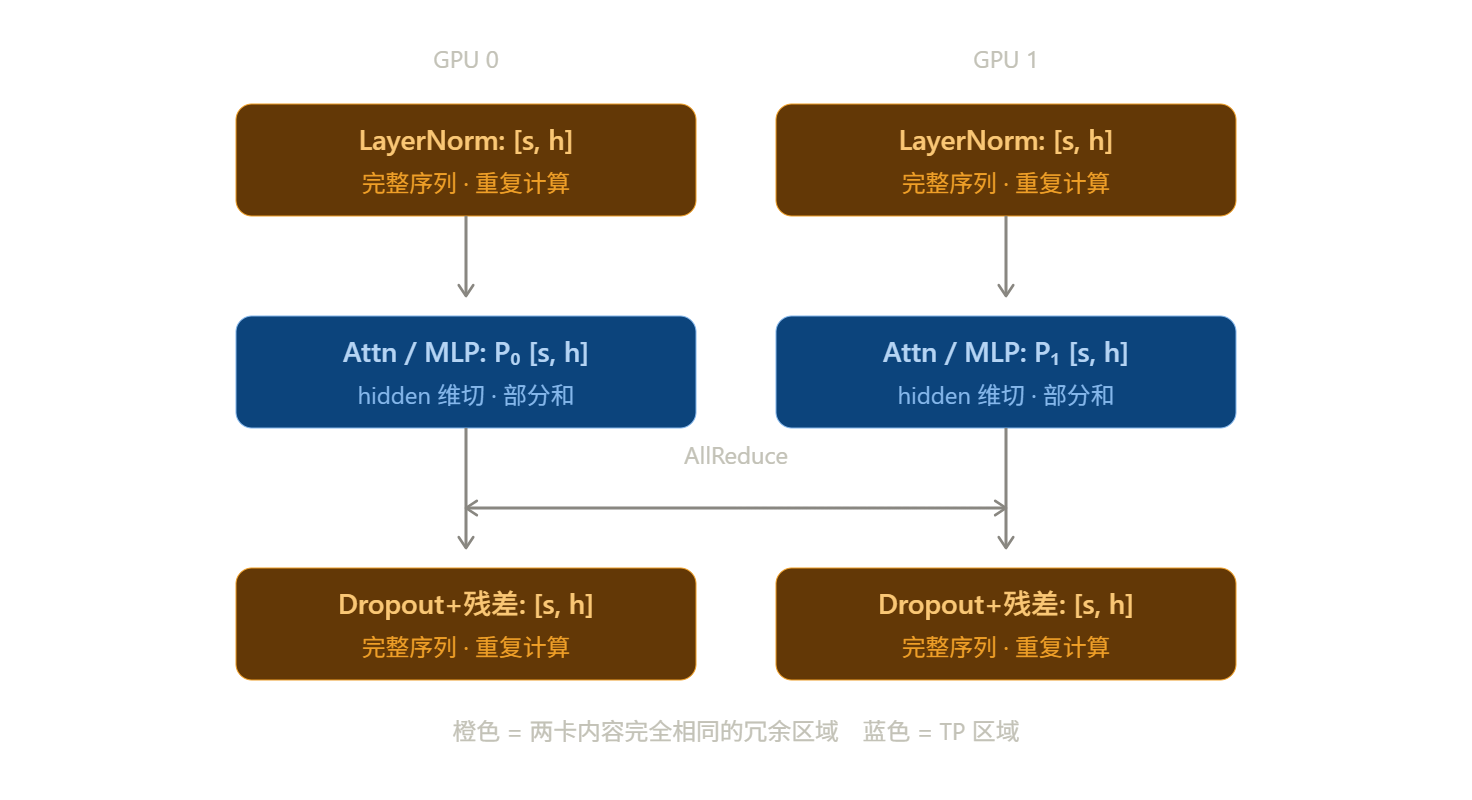
橙色区域中,两张卡上面计算的内容一模一样,这是浪费。因为 LayerNorm 沿着 hidden 维归一化,要算一个 token 的 LN,必须拿到它完整的 维向量。而 TP 恰恰把 hidden 维切开了,每张卡只有一半。所以 LN 没法用 TP 切,Megatron 只能让每张卡都持有完整的 hidden 维,各算同一份结果。Dropout 同理。
LayerNorm 和 Dropout 虽然不能沿着 hidden 维切,但是它们是逐 token 独立的。所以可以沿着序列维切。GPU0 负责 token 0 ~ s/2,GPU1 负责 token s/2 ~ s,各算各的,不需要任何通信,显存直接减半,这就是 SP。
加上 SP 之后,同一个 block 变成:
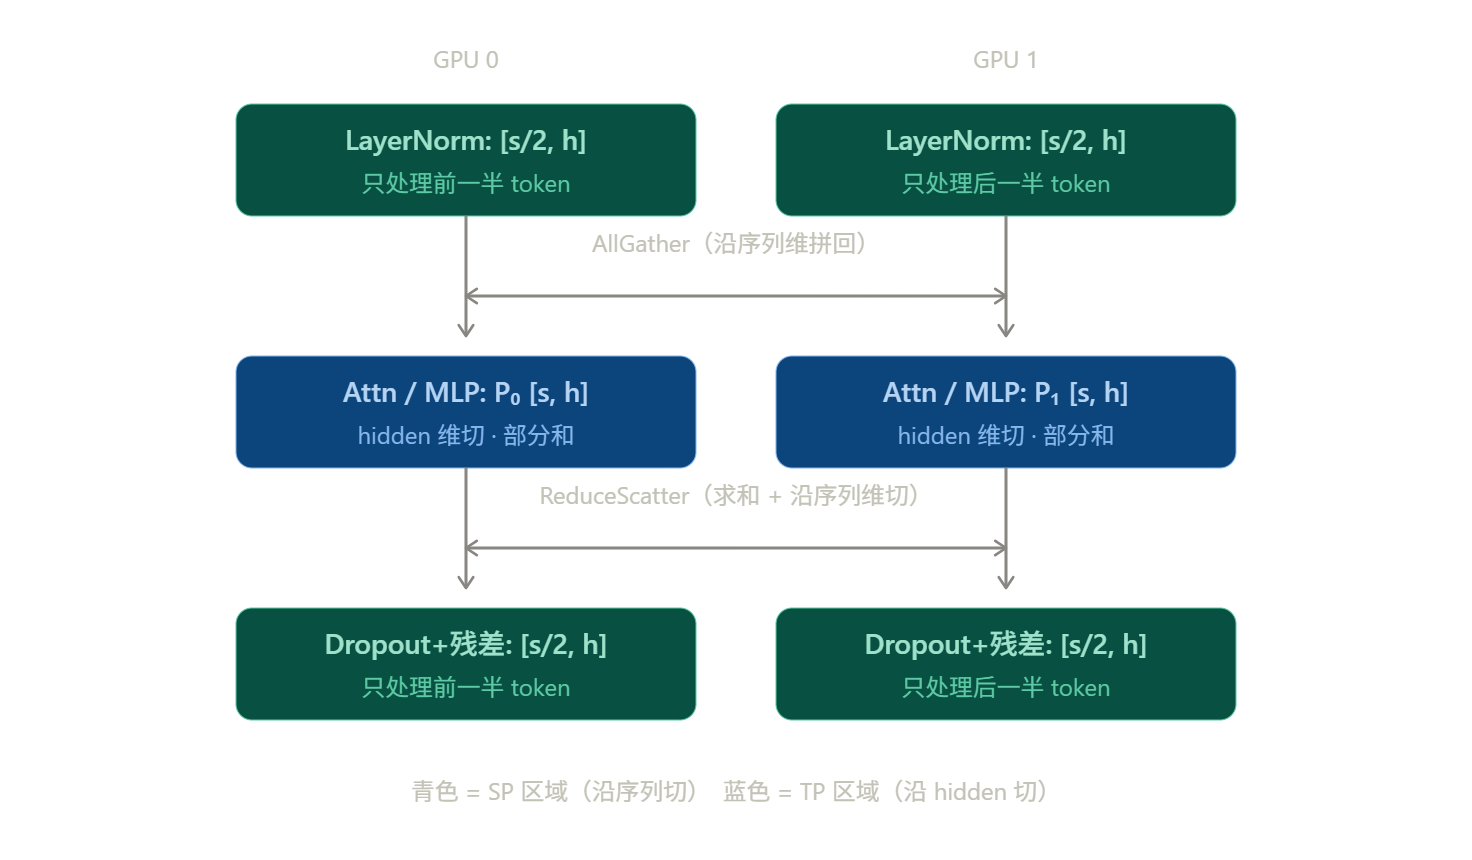
对比两张图可以发现,唯一改动就是将橙色区域的形状从 [s, h] 变成了 [s/2, h]。而这一处改动也导致了两处通信方式的变化。
AllGather:SP 区域出来是 [s/2, h],但是 TP 区域(尤其是 attention)必须看到完整序列(算 attention score 时一个 token 需要跟所有 token 做内积,只有一半序列算不了。所以进 TP 之前必须将序列维度拼回完整的 ,也就是 AllGather 操作。
下面这一段,如果用 AllReduce:两张卡各得一份完整的 [s, h] 的 ,然后 GPU0 把后一半扔掉,GPU1 将前一半扔掉。通信搬运了一半用不上的数据,中间还要物化出完整的 [s,h] 缓冲区。
如果用 ReduceScatter:求和与切分是同一个 collective,GPU0 直接收到 的前一半,GPU1 直接收到后一半,没有中间的完整张量。
总结起来就是:
SP 和 TP 是在两个正交的维度切分。没有 SP 的时候也不需要 ReduceScatter + AllGather,因为 vanilla TP 里面序列维全是完整的 ,没有转换。
PP(Pipeline Parallel)
PP 是按层切分模型,不同 stage 放在不同设备上面, forward 时 stage 算完将激活值传给 stage ,反向时 stage 把梯度传回 stage 。
这是 P2P 通信,因为通信只发生在相邻两个 stage 之间,所以用 Send/Recv 而不是 Allreduce/Allgather 这类 collective primitive。
EP(Expert Parallel)
EP 是 MoE 的特有场景,不同 expert 放在不同设备上面,而每个 token 被 router 动态分配给哪个/哪些 expert 是数据依赖的,运行时才知道的。
所以每张卡需要将自己持有的 token 按照路由结果,发送到 token 对应 expert 所在的卡上(dispatch),计算完之后再把结果发回原来的卡(combine)。每个 rank 需要给每个其他 rank 发送不同数量、不同内容的数据,这正是 All-to-All 的定义,也是 EP 通信开销的主要来源,尤其是当节点间带宽成为瓶颈的时候。
PP 中可以通过减小 microbatch 的大小,来减少 bubble 的占比。
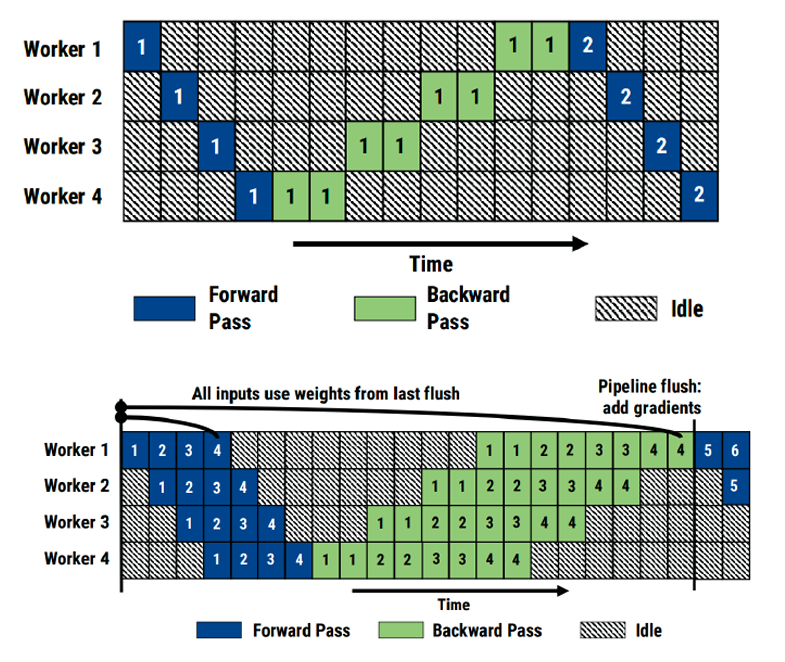
下半张图中 :灰色格子就是 bubble。 是 pipeline stage 数,也就是模型被切成几段、用几张卡做流水线; 是 microbatch 数,一个 global batch 被切成几份送进流水线。
以最后一个 stage 的时间轴为例,整个迭代总时长可以这样拆分:
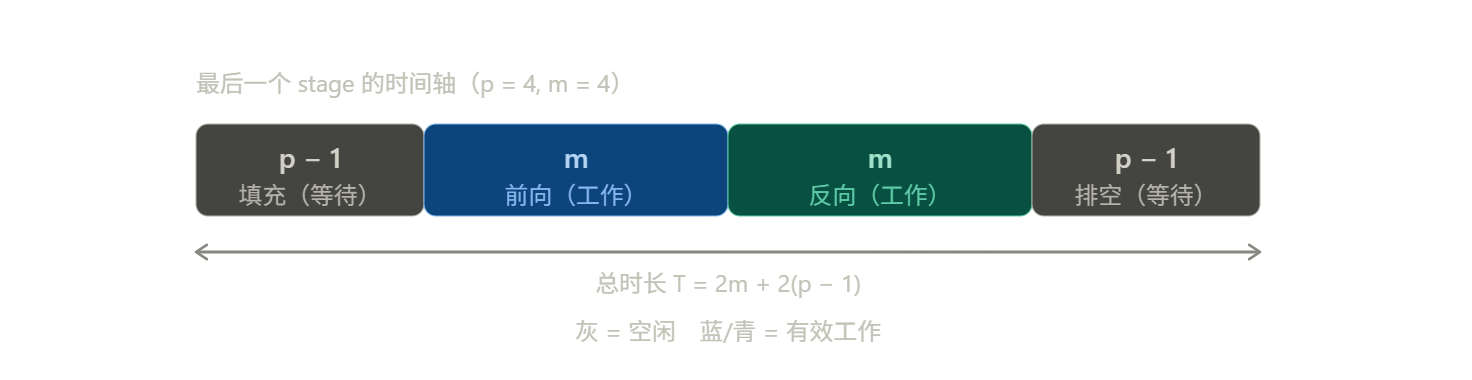
从图中可以得出:
因此减小 mircobatch——也就是增大 m,可以减小 bubble ratio。 上面用最后一个 stage 推导,是因为它的空闲出现得较为整齐,但是不同 stage 的推导结果是相同的,用任意一行来推导总时长都是等价的。
DP(Data Parallel)
DP 中每张卡拿到完整的模型副本和不同的数据分片,反向传播之后每张卡算出来的梯度只是基于自己那份数据的,需要将所有副本的梯度加权平均才能保证参数更新一致。
ReduceScatter + AllGather 对应的是 ZeRO / FSDP 使用的这类显存优化方案:每张卡最终只需要维护更新参数/梯度/优化器状态的一个分片,没必要先 AllReduce 出完整梯度再各自丢弃大部分,不如直接在 ReduceScatter 把梯度归约的同时分片到各卡,之后如果需要完整权重参数再 AllGather 回来临时拼完整,用完即释放。这样一来通信量和 AllReduce 理论上相当,但是峰值显存大幅度下降。
关于数据搬运的功耗
数据搬运的功耗较大:
- 一次 INT 运算:~ 1 pJ
- 一次浮点运算:~ 20 pJ
- 从 SRAM 中读取 64 bit 数据:~ 26pJ
- 从 low power mobile DRAM 读取 64 bit 数据:~ 1200 pJ