Machine Models
| Shared Memory | Distributed Memory | SIMD |
|---|---|---|
| 不同 Processors 处理自己的指令流 | 不同 Processors 处理自己的指令流 | 只有一个指令流 |
| Processors 之间通过读写共享 memory 进行通信 | 直接通过网络发送信息进行通信 | 通过 memory 进行通信 |
| 读写内存的开销固定(理想化假设) | 通信时间只跟消息大小有关,跟位置无关(理想化假设) | 假设算术单元的数量是无限的(理想化假设) |
Basic Kinds of Simulation
- 离散事件系统
- 原子系统
- 集总系统(ODE)
- 连续系统(PDE)
| 系统 | 空间/实体 | 时间 | 常见数学模型 |
|---|---|---|---|
| Discrete event | 离散 | 离散 | 离散事件模型 |
| Particle | 离散 | 连续 | ODE |
| Lumped system | 离散 | 连续 | ODE |
| Continuous system | 连续 | 连续 | PDE |
Particle systems 是 lumped systems 中的一种 许多 simulation model 其实在不同层面是不同系统,并且综合了很多层次的技巧
Discrete Event Systems
模拟离散事件系统需要将区域解耦,也就是分区。
不同区域的推进方式:
- 同步系统:在每个离散时间步都会计算所有转移函数,也被称为状态机
- 异步系统:只有当输入变化(基于另一个系统的 event)的时候才会对转移函数求值;也被称为事件驱动仿真
Synchronous Simulation
- 如何减少分区边界之间的开销?minimize “surface to volume ratio” of partition(类似于细胞学中的 表面积/体积 理论)
- e.g. 对一个正方形网格进行分区,采用方块分区相较于采用横向长条分区,通信量大大减少
Asynchronous Simulation
异步模拟,仅当接收到外部 event 的时候才会更新状态;没有 global 时间步,但是独立的时间包含时间戳。
- 异步模拟看起来很高效,但是很难并行化,因为不知道什么时候会接收到一个 event
所以怎么模拟?有两种策略:
- Conservative:只有确定未来不会出现更早的输入时,才继续往前模拟。如果存在环,还需要额外检测死锁机制。
- Speculative/Optimistic:先假设不会有新输入,直接往前面算;这种方法更激进,也更容易获得并行度;如果猜错,就需要 fallback 并重新计算。
- 在优化过程中很难同时兼顾 load balance 和 locality:因为系统中很有可能只有一小部分是活跃的,将活跃部分的工作交给一个 processor 可以带来 locality,减少了通信开销,但是负载不均衡;将活跃部分分散到不同 processor 可以摊开负载,但是 locality 少了,通信开销增加。
Particle Systems
- 原子系统有有限个“原子”,在空间中的运动遵从 Newton’s Laws,时间和位置是连续的。
- 原子系统中原子的受力:force = external_force + nearby_force + far_field_force
Parallelism in External Forces
External forces 指的是粒子系统之外的力,通常不需要考虑其他粒子的位置,是环境/外界给这个粒子施加的力。
- 外力施加在每个粒子是独立的,所以可以将粒子平均地分配到 processors 上面,因为 locality 在这里不是问题。
Parallelism in Nearby Forces
Nearby forces 是粒子之间的相互作用产生的力,因此需要粒子间通信。
- 一个常见的并行模型:将空间切分成很多区域,每个处理器负责一个区域。
- 但是这会带来一些问题:
- 边界通信:不同区域粒子之间由于需要知道邻近的信息,所以需要进行通信
- 负载均衡:粒子可能不是均匀分布的,所以处理较快的处理器需要等待处理较慢的处理器
- 解决方案:
- 给每个区域增加一个 ghost zone/Halo 区域:Halo 中是相邻分区中边界数据的一份复制,相当于是让两个分区产生了重叠。同时,需要减少 surface-to-volume ratio,尽量使用 squares 而不是 slabs。
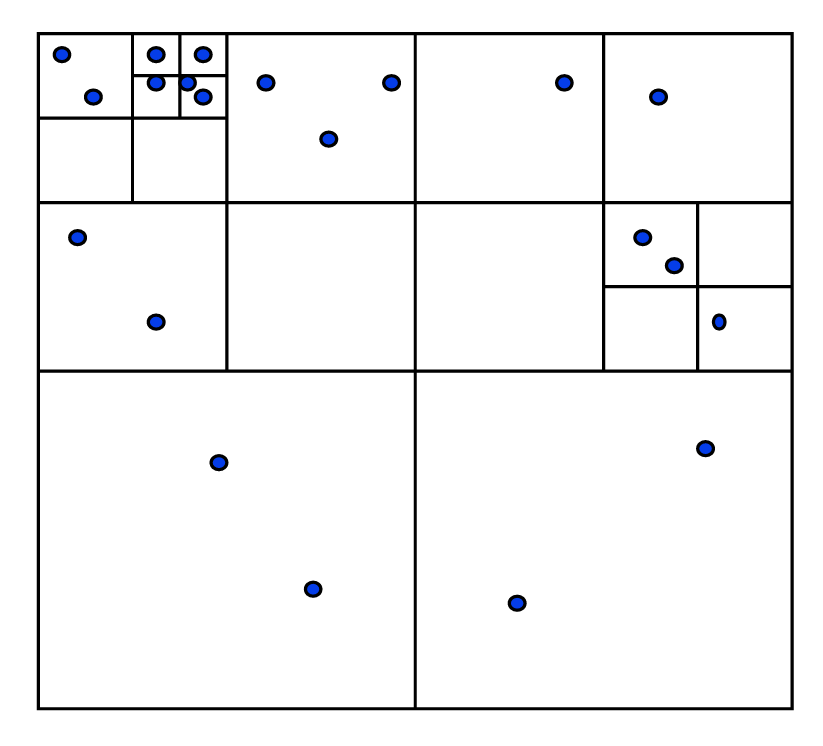
- 空间可以不要求均分,而是让每个区域拥有差不多数量的粒子。二维空间可以采用 Quad-tree,三维空间可以采用 Oct-tree。二维空间的例子见右图:
Parallelism in Far-Field Forces
Far-field force 是 all-to-all 的力(例如引力),也就需要 all-to-all 的通信。所以这里分块已经起不到作用了,因为每个粒子都需要 visit 另外所有粒子。
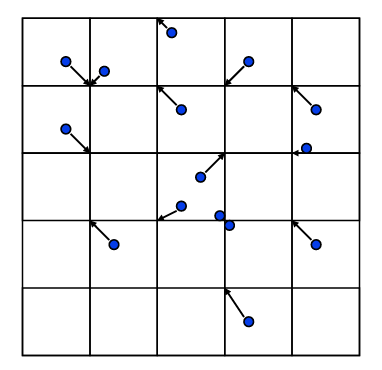
- 处理方法:粒子网格系统 Particle-Mesh:在原来的粒子空间上面叠加一个规则网格,将粒子的质量/电荷等信息分配(scatter)到网格点上面,然后建立离散 Poisson 方程,得到线性方程组,再用 FFT/Multigrid 等方法求解方程组,解得每个 grid point 的势,最后通过有限差分计算每个 grid point 的梯度,再插值回原来粒子实际的点。
Lumped Systems:ODEs
System of Lumped Variables:集总变量系统。非集总模型中的变量跟空间位置和时间都有关,集总模型就是将空间位置的变化近似掉了,例如,电路系统中忽略了导线内部的电压变化,将整个系统简化成一个 graph,只保留每个节点的电压等信息。所以 Lumped system 就是指保留有限个只依赖时间的变量,自然变成了 ODE 问题。
这里 ODE 中出现的矩阵往往是稀疏矩阵,因为每个节点的状态往往只跟周围几个节点有关。
有了 ODE 我们可能会需要求解一类问题:计算变量在某个时刻 t 的值,也就是时间推进问题。
时间推进
假设 这里 是系统当前状态, 是稀疏矩阵, 是状态变化速度。 存在两种求解方法:
显式方法
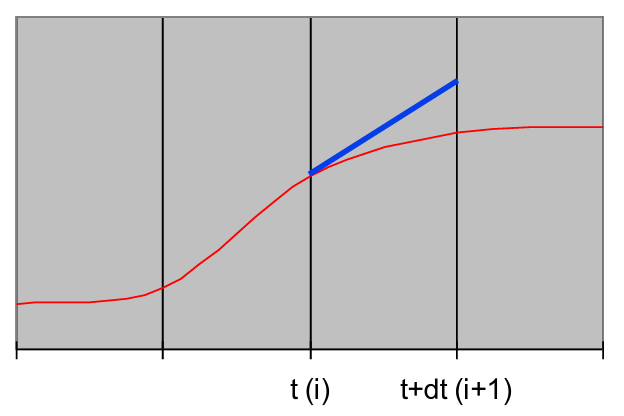
直接用斜率近似出下一个点: 这就是前向欧拉,之所以称之为显式方法是因为这个公式右边都是已知量。 这种方法的最大问题是稳定性,如果系统变化很快,用这种方法可能产生大幅偏差,所以 Explicit Euler 可能需要非常小的 。
隐式方法
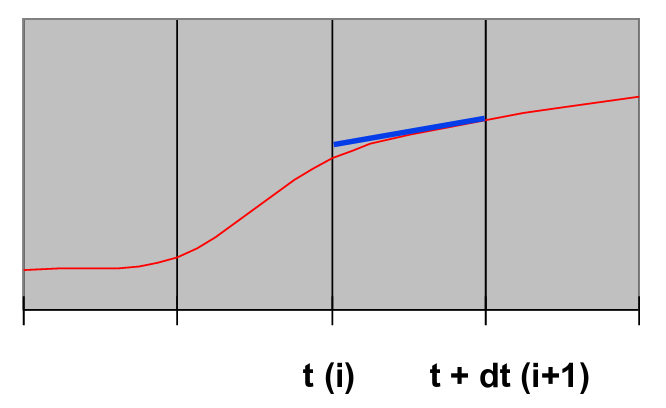
隐式方法,也就是 Backward Euler 用的是下一个时刻的“斜率”: 整理得: 也就是说,每个时间步都需要求解这个方程组。 求解方程组的开销要比 SpMV 的开销大得多,但是由于稳定性要好很多,时间步可以设置得很大,所以适合用于刚性问题。
SpMV
SpMV in Compressed Sparse Row(CSR) Format
CSR 是一种压缩稀疏行的矩阵存储方式,按照行存储矩阵的非零元素,主要使用三个数组:val, ind, ptr。val 存储所有非零元素的数值;ind 存储每个非零元素所在的列的索引;ptr 记录每一行的非零元素在 val/ind 中的起始位置。
CSR 下的 SpMV,对于第 行,非零元素对应:
因此:
对应代码:
for (int i = 0; i < m; i++) {
    for (int k = ptr[i]; k < ptr[i + 1]; k++) {
        y[i] += val[k] * x[ind[k]];
    }
}
CSR 的优势是不需要存储大量的 ,能够大幅减少存储空间,并减少不需要的乘法;但是由于 x[ind[k]] 的访存大概率不是连续的,可能导致较多的 cache miss,因此 SpMV 通常是 memory-bound。
并行化 CSR 格式的 SpMV 可以直接让不同 processor 处理不同行块;对于 x 向量的存储,一种方法是直接让 processor 都保存一份 x 的完整副本,另一种方法是只保存对应行的 x,然后让 processor 之间进行必要的通信。
Matrix Reordering via Graph Partitioning
一个理想情况是矩阵是块对角矩阵,这样每个 processor 负责一个 block,所有计算都可以在本地完成,不需要通信。 但是实际上很多矩阵不能满足这个条件,所以需要重排,也就是重排矩阵的列和 x 中元素的位置。 但是怎么知道哪些数据关系紧密?这就需要 Graph Partitioning,在分区过程中要把联系紧密的数据尽量放在同一个 partition,同时减少 partition 之间的连接。但是分区的时候还需要考虑负载均衡,不能仅考虑跨分区的 edge。
Partial Differential Equations(PDE)
PDE,位置 和时间步 都是变量。与 ODE 相同,都具有两种解法,分别是显式和隐式:显式解法是一个 SpMV,也称为 Forward Euler;隐式解法是 sparse matrix solve,也称为 Backward Euler。
同时还存在另一种方法,叫做 Trapezoidal Rule,这种方法不看中点和起点,而是使用两点之间的平均,时间精度是二阶,稳定性要更好,但是需要完成一次 SpMV 和一次方程组求解。
Meshes
实际的 mesh 通常不是规则的 1D/2D/3D,而是不规则的形状,主要分为三类:
- Composite meshes:复合网格,将很多规则 mesh 拼起来,但是每一块的整体形状可以弯曲
- Unstructured Mesh:非结构化网格,这里不存在简单的二维数组关系,而是记录每个节点的邻居,自然变成一种 graph
- AMR:自适应动态网格,变化较快的区域会使用细网格,变化较为缓慢的区域会使用粗网格。AMR 决定什么区域需要使用细网格,是通过一阶导/二阶导/不同分辨率的结果来判断的。
- AMR 的操作单位不是单个网格,而是将相邻几个细网格组织成一个 patch,将 patch 变细。
- AMR 计算的并行方式主要是,一个 processor 负责几个 patch,不同 processor 的计算量可能差异很大,需要保证 load balance。patch 内部也可以存在并行,比如 OpenMP, CUDA, SIMD。
总的来说,不规则 mesh 主要会带来这些问题:
- 首先是如何生成这些网格?这在 3D 空间里面尤为困难。
- 如何分区?
- 如何为线性方程组求解设计 Direct Solver 和 Iterative Solver?
- 上面这些问题还仅仅是单节点的问题,在并行环境下面更困难。